
報道へのクリック率を最大93%減らすと知りながら開発を続けた巨大テック企業の社内文書が公開された
OpenAI, Microsoft Knew AI Posed 'Existential Threat' to News, Court Docs Show
ポイント
- OpenAIとMSが、AIが報道機関に「実存的脅威」と認識し開発継続
- NYT訴訟で公開された文書が判明し、クリック率最大93%低下と認識
- これはフェアユースの法的防御を揺るがし、企業の認識が問われる事態だ
OpenAIとMicrosoftの経営幹部や社員が、自社の生成AIサービスが報道機関にとって「実存的脅威」になると社内で認識しながら製品開発を続けていた。その事実を示す社内文書が、ニューヨーク・タイムズによる著作権侵害訴訟の未開示資料の公開によって明らかになった。TechCrunchが2026年9月17日、この内部資料の内容を詳報した。
「人類史上最大の労働の窃盗」と社内で呼んでいた
公開された資料によれば、MicrosoftのApplied Science部門のディレクター、ブレント・ヘクト氏が2023年1月の社内メモで、自社のAIスクレイピング(大量のウェブデータを自動収集する行為)を「前代未聞の規模の驚くべき窃盗であり、人類史上最大の労働の窃盗だ」と表現していた。
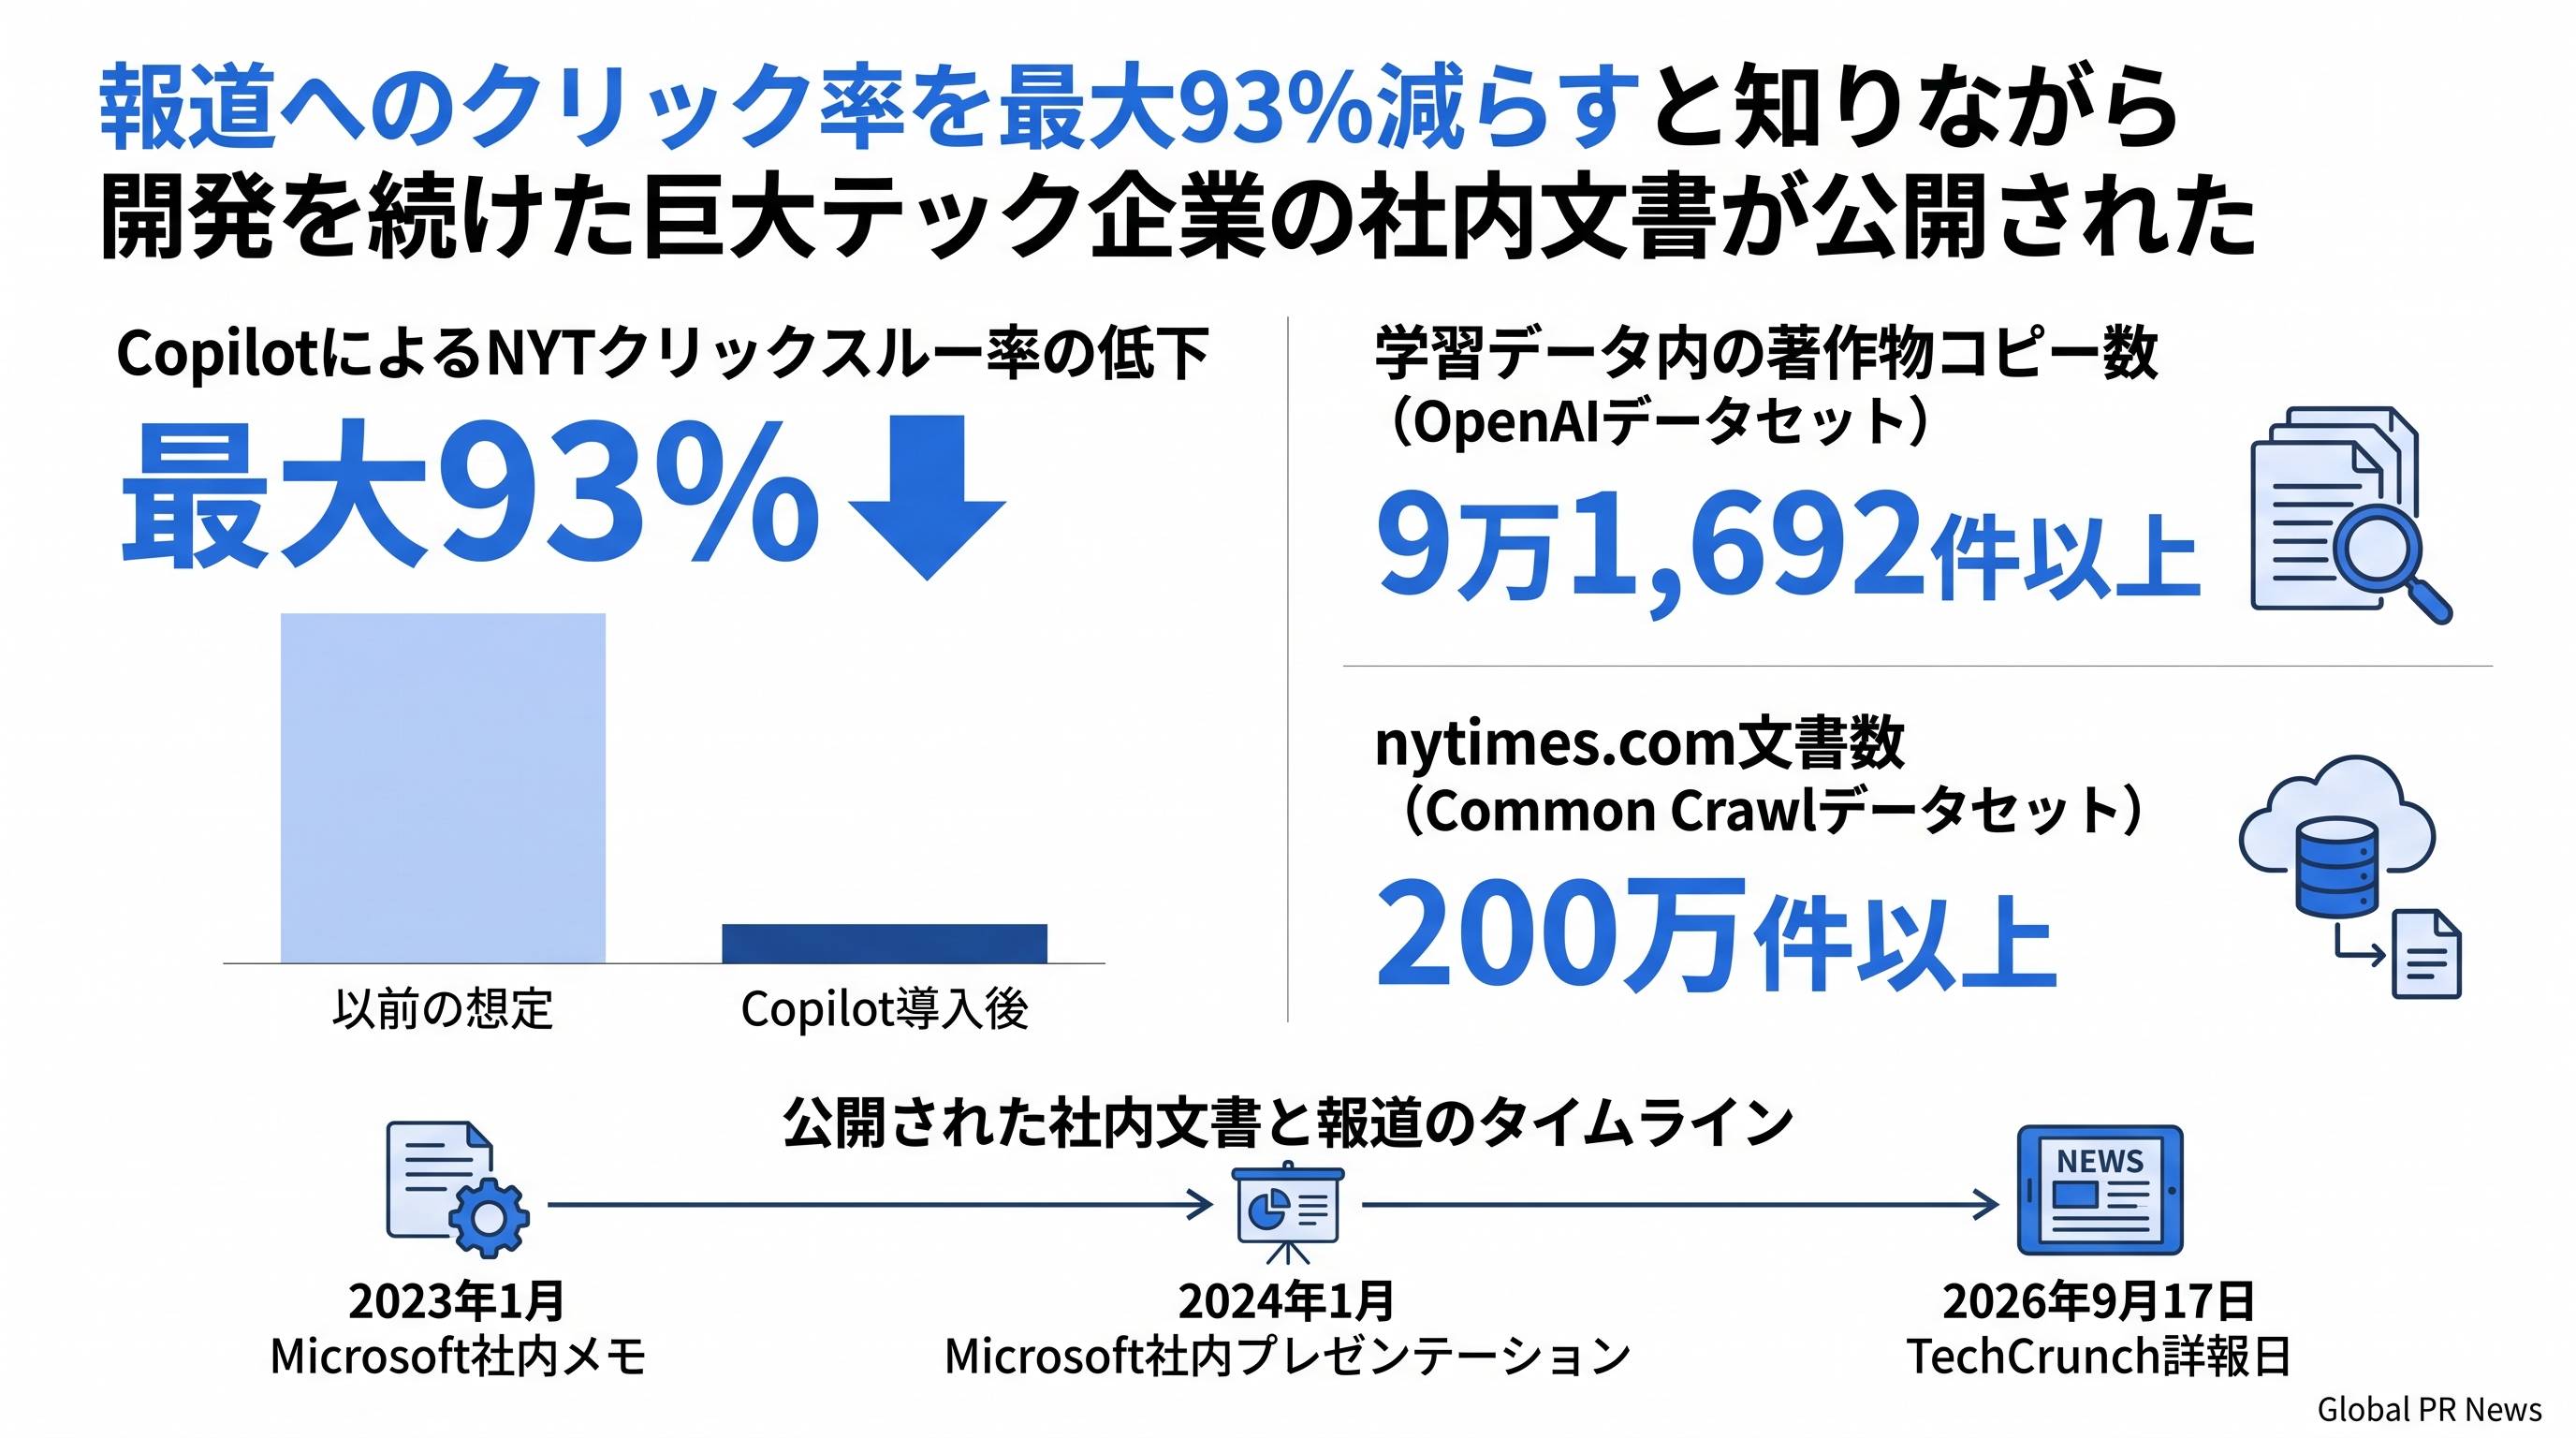
また同氏が2024年1月に作成した社内プレゼンテーションでは、MicrosoftのAIアシスタント「Copilot(コパイロット)」の回答機能によって、ニューヨーク・タイムズへのクリックスルー率が従来のBing検索と比べて最大93%低下したとするMicrosoft自身のデータが示されていた。ヘクト氏はこの状況を「ドゥームループ(連鎖的な悪化)」と呼び、「自社モデルのパフォーマンスとウェブ全体のパフォーマンスを同時に損なう」と警告していた。
社内文書にはさらに、「エンドプロダクトが不可欠なサプライヤーの経済的基盤を脅かすのは極めて異例の事態だが、それがまさに我々がLLMビジネスにおいて『コンテンツサプライチェーン』に対して生み出した状況だ」という記述もあった。
OpenAI側も「ニュースの代替品になる」と社内で認識
OpenAIのChatGPT担当責任者ニック・タ―リー氏は社内のやりとりで、ChatGPTのような製品が出版社にとって「実存的脅威」であり、「大部分においてニュースの代替品になっている」「精度が上がるほどその代替性は増す」と記していた。OpenAIのグレッグ・ブロックマン社長は、同社のモデルが「ニュースに秀でている」と述べていた。
Microsoftのサティア・ナデラCEOは今年行われた証言録取で、チャットボットとの会話が「AIプラットフォーム上で情報をその場で提供することで、元のソースを参照する必要をなくした」という点で、元の情報源へのアクセスを代替していると認めた。さらにナデラ氏は、「ペイウォール(有料会員向けの閲覧制限)に守られたコンテンツを利用しようとする者は誰であれ、ライセンスを取得すべきだ」とも述べ、OpenAIがペイウォールを越えてコンテンツをスクレイピングしていた事実を事前に知っていれば「OpenAIにモデルの再学習を求める権利を行使していた」と証言した。
9万件超のコピー、ペイウォール回避の手口も詳細に
資料が示すデータの規模も衝撃的だ。今回初めて明らかになった内容として、OpenAIの学習データセットだけで、ニューヨーク・タイムズ、デイリー・ニュース、調査報道機関Center for Investigative Reportingが発表した著作物のコピーが9万1,692件以上含まれていた。さらにウェブ上の大規模公開クロールデータ「Common Crawl」から作成したデータセットには、nytimes.comのページだけで200万件以上の文書が含まれていたことが判明した。
ペイウォールの回避方法についても記録されていた。OpenAIの研究者ニック・ライダー氏がブロックマン氏に「ニューヨーク・タイムズのペイウォールを回避するハックを見つけた」と伝えた際、ブロックマン氏は「ああ、いいね」と返答していた。また、学習データから著作権表示を意図的に取り除いていたことも明記されており、その理由として研究者たちが「モデルが著作権表示をユーザーに出力することを望まなかった」とされている。
加えて資料には、MicrosoftがOpenAIからGPT-3の学習データセット全体を受け取り、自社製品への導入可能性を評価するために使用したこと、「Project Taxi」「Project Mango」と呼ばれる取り組みを通じて双方向にデータを提供し合っていたことも記されている。Project Mangoによって構築されたデータセットには、少なくとも16万903件の報道機関発の著作物のコピーが含まれていた。
ニューヨーク・デイリー・ニュースの代理人を務めるスティーブン・リーバーマン弁護士は「今回初めて示されたこの証拠は、OpenAIとMicrosoftが自分たちの行為が間違っていると知っていたことを示している」との声明をTechCrunchに提供した。OpenAIとMicrosoftはいずれもコメント要請に応じなかった。
この訴訟は、ニューヨーク・タイムズが3年前にOpenAIとMicrosoftを著作権侵害で提訴したものだ。生成AIモデルの学習に著作物を使うことが「フェアユース(著作物の公正利用)」として合法かどうかは現時点で明確な判断が出ておらず、これまで裁判所はAI企業側の主張に概ね好意的だった。しかし今回公開された内部資料の複数の記述、特に「元の著作物の市場を代替・毀損しない」というフェアユースの要件に反する認識が企業内部に存在していた事実は、その法的防御の根拠を揺るがすものとして注目されている。
情報ソース一覧
- Microsoft幹部がAIスクレイピングを「人類史上最大の労働力窃盗」と呼んでいたことが、新たに開示された文書で明らかに Microsoft exec called AI scraping ‘the largest theft of labor in human history,' new unredacted filings reveal techcrunch.com
- OpenAIのスタッフはAIがパブリッシャーに「実存的脅威」をもたらすことを知っていたとNew York Timesが主張 OpenAI staff knew the 'existential threat' AI posed to publishers, New York Times claims finance.yahoo.com
- テック企業のスタッフは、AIツールがパブリッシャーに「実存的脅威」をもたらすことを知っていた Tech staffers knew AI tools posed 'existential threat' to publishers nypost.com
- MicrosoftディレクターはAIスクレイピングを「人類史上最大の労働力窃盗」と呼び、OpenAIの責任者はChatGPTをパブリッシャーにとって「実存的脅威」と烙印 — これらの暴露はNYT訴訟で提出された訴訟要約書から Microsoft director called AI scraping ‘the largest theft of labor in human history,’ while OpenAI head brands ChatGPT an ‘existential threat’ to publishers — revelations come from legal briefs filed in NYT lawsuit finance.yahoo.com
- OpenAIのChatGPT責任者が、開示された文書でパブリッシャーが「実存的脅威」に直面していると警告 OpenAI’s Head of ChatGPT Warned Publishers Faced an ‘Existential Threat’ in Unsealed Docs www.thewrap.com
- The New York Times 対 Microsoft および OpenAI The New York Times v. Microsoft and OpenAI en.wikipedia.org/wiki/The_New_York_Times_v._Microsoft_and_OpenAI
- OpenAIとMicrosoftの幹部は、AIがウェブ全体を傷つける「破滅的なループ」を引き起こす可能性があることを知っていた OpenAI and Microsoft leaders knew AI may cause 'doom loop' hurting entire web www.washingtonexaminer.com